Концепция медиа
«Нуарный архив» — культурно-аналитическое медиа о детективной культуре, нуаре и искусстве расследования.Слоган: «За пределами сюжета».«Нуарный архив» — нишевое русскоязычное медиа, посвящённое детективу и нуару в литературе, кино, театре и видеоиграх. Проект рассматривает детектив не только как развлекательный жанр, построенный вокруг преступления и поиска виновного, но и как способ исследования человеческой психологии, общественных противоречий и морального выбора.Основная идея проекта — показать, что за привычными детективными сюжетами скрываются более сложные вопросы: почему человеку необходимо знать правду, всегда ли справедливость совпадает с законом, можно ли доверять рассказчику и почему зрителю иногда легче сопереживать преступнику, чем следователю.
Цель проекта
Стать одной из ведущих русскоязычных площадок, объединяющих любителей детективной культуры, исследователей, читателей, зрителей и авторов.Основные задачи медиа: — Анализировать классические и современные произведения детективного жанра. — Рассказывать об истории нуара и его влиянии на современную культуру. — Объяснять художественные приёмы, структуру расследования и особенности криминальной драматургии. — Создавать тематические подборки книг, фильмов, сериалов, спектаклей и видеоигр. — Формировать сообщество читателей, заинтересованных в глубоком обсуждении жанра.
Целевая аудитория
Аудитория «Нуарного архива» — люди, которые интересуются детективами, психологическими триллерами, нуаром, криминальными историями и культурной аналитикой.Проект ориентирован как на широкую аудиторию, ищущую качественные рекомендации, так и на читателей, которым интересны история жанра, особенности повествования и культурные смыслы произведений.
Формат и каналы распространения
Основная площадка проекта — Telegram-канал, в котором публикуются аналитические статьи, рецензии, подборки, короткие заметки, визуальные материалы и интерактивные опросы.Дополнительные площадки — VK, YouTube и собственный сайт, который в перспективе станет полноценным архивом материалов.
Уникальность проекта
В отличие от обычных каналов с рекомендациями фильмов и книг, «Нуарный архив» не ограничивается пересказом сюжетов и оценкой произведений. Медиа исследует, как устроены детективные истории, какие художественные приёмы используют авторы и почему жанр продолжает оставаться актуальным.Главный принцип проекта — не пересказывать детектив, а расследовать сам детектив.
Источники данных для медиа
Для создания контента «Нуарный архив» использует несколько категорий источников, которые позволяют получать информацию о новых произведениях, изучать историю жанра, отслеживать культурные тенденции и анализировать интересы аудитории.
1. Первичные источники
Основными источниками информации выступают официальные сайты издательств, киностудий, театров и разработчиков видеоигр. Из них редакция получает сведения о новых книгах, фильмах, спектаклях и играх, датах премьер, авторах и содержании произведений.Важнейшим источником являются сами произведения: книги, фильмы, сериалы, театральные постановки и видеоигры. Их непосредственное изучение позволяет создавать самостоятельные аналитические материалы, а не пересказывать чужие рецензии.Дополнительно используются интервью с писателями, режиссёрами, сценаристами и исследователями жанра, которые помогают понять авторский замысел и культурный контекст произведения.
2. Вторичные источники
Для дополнительной информации и анализа критического восприятия используются специализированные платформы.IMDb — для получения информации о фильмах, сериалах, актёрах и режиссёрах.Rotten Tomatoes — для изучения профессиональных рецензий и критических оценок фильмов.Goodreads — для анализа читательских отзывов, рейтингов и популярности детективной литературы.Metacritic — для сопоставления оценок фильмов, сериалов и видеоигр.Google Scholar — для поиска научных исследований по истории детектива, теории повествования и культурологии.Также используются материалы литературных журналов, кинокритических изданий, библиотечных архивов и культурных медиа.
3. Внутренние источники данных
Отдельную категорию составляют данные, которые формируются в процессе работы самого медиа.К ним относятся статистика просмотров публикаций, реакции подписчиков, комментарии, пересылки, результаты опросов и динамика аудитории Telegram-канала.Эти данные позволяют понимать, какие темы вызывают наибольший интерес, какие форматы работают эффективнее и как следует корректировать контент-план.Например, если публикации о психологических триллерах получают больше реакций, редакция может увеличить количество материалов на эту тему.При этом статистика не должна полностью определять редакционную политику: главная задача «Нуарного архива» — сохранять аналитическую глубину и культурную направленность.
4. Принципы отбора источников
«Нуарный архив» придерживается следующих правил:
- Проверять фактическую информацию по первоисточникам.
- Отделять авторскую интерпретацию от подтверждённых фактов.
- Указывать источники при использовании статистики, цитат и исследований.
- Не использовать неподтверждённые слухи как основу новостных публикаций.
- Учитывать авторские права при работе с изображениями, текстами и видеоматериалами.
- Не раскрывать сюжетные повороты без предупреждения о спойлерах.
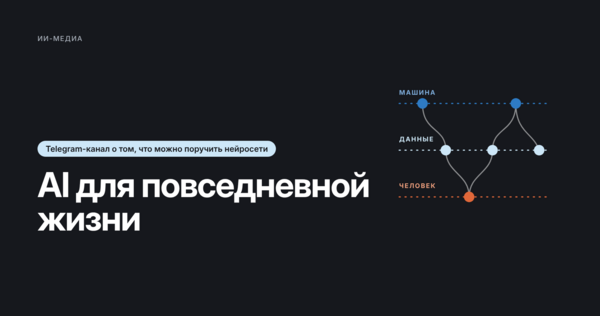
Схема данных с разделением на человеческую и машинную обработку
Для работы «Нуарного архива» предполагается смешанная модель обработки информации. Автоматизированные сервисы выполняют повторяющиеся технические задачи, а человек отвечает за анализ, интерпретацию и окончательные редакционные решения.
Весь процесс делится на несколько последовательных
Этап 1. Сбор информации Машинная обработка: автоматизированные сервисы отслеживают обновления официальных сайтов, RSS-лент и других доступных источников. Система собирает названия материалов, даты публикаций, ссылки и краткие описания. Человеческая обработка: редактор определяет список надёжных источников и проверяет, насколько найденная информация соответствует тематике медиа.Этап 2. Фильтрация и классификация Машинная обработка: алгоритмы удаляют повторяющиеся материалы и распределяют информацию по категориям: литература, кино, театр, видеоигры, история жанра и культурная аналитика. Человеческая обработка: редактор оценивает значимость каждой темы, выбирает наиболее интересные материалы и определяет, какие из них подходят для будущих публикаций.Этап 3. Проверка и анализ информации Машинная обработка: искусственный интеллект помогает структурировать собранные сведения, выделять ключевые факты, создавать краткие сводки и находить возможные противоречия между источниками. Человеческая обработка: автор самостоятельно изучает произведение, проверяет факты и формирует аналитическую позицию. Именно на этом этапе появляется оригинальная интерпретация, которая отличает «Нуарный архив» от обычных новостных и рекомендательных каналов.Этап 4. Создание контента Машинная обработка: ИИ-сервисы могут предлагать структуру публикации, варианты заголовков, краткие описания и идеи для визуального оформления. Человеческая обработка: автор пишет окончательный текст, добавляет собственные выводы, выбирает примеры и адаптирует материал под стиль медиа. Редактор проверяет содержание, грамотность, достоверность и соответствие концепции проекта.Этап 5. Публикация Машинная обработка: сервис отложенного постинга размещает утверждённые материалы в Telegram и других социальных сетях согласно контент-плану. Человеческая обработка: редактор заранее утверждает публикацию, проверяет оформление, изображения, ссылки и время выхода материала.Этап 6. Аналитика результатов Машинная обработка: сервисы собирают статистику просмотров, реакций, комментариев и пересылок, формируют отчёты и показывают дина
Хранение данных
Для хранения информации предполагается создание единой редакционной базы в Notion или Airtable.В ней будут содержаться названия материалов, категории, ссылки на источники, даты, краткие описания, ответственные редакторы и статусы публикаций.Каждый материал проходит несколько стадий: идея, сбор информации, подготовка текста, редактура, утверждение и публикация.Такая система позволяет сохранять архив источников, отслеживать процесс подготовки контента и избегать повторения тем.
Гайдлайны для автоматизированных сервисов
Автоматизированные сервисы «Нуарного архива» должны помогать редакции выполнять технические задачи, но не заменять авторскую работу и экспертный анализ.Для каждого инструмента устанавливаются отдельные правила использования.
1. Сервис автоматического сбора информации
Предполагаемые инструменты: RSS-агрегатор Feedly, n8n или Make, официальные API доступных платформ.Задача сервиса — отслеживать появление новых материалов по заданным темам и передавать информацию в редакционную базу.Правила работы:
- Использовать только заранее утверждённый список источников.
- Сохранять оригинальную ссылку, название и дату получения материала.
- Проверять наличие повторов.
- Не обходить платный доступ и технические ограничения сайтов.
- Не считать автоматически найденную информацию достоверной без проверки.
- Не публиковать найденные материалы напрямую.Результат: структурированная подборка потенциально интересных тем