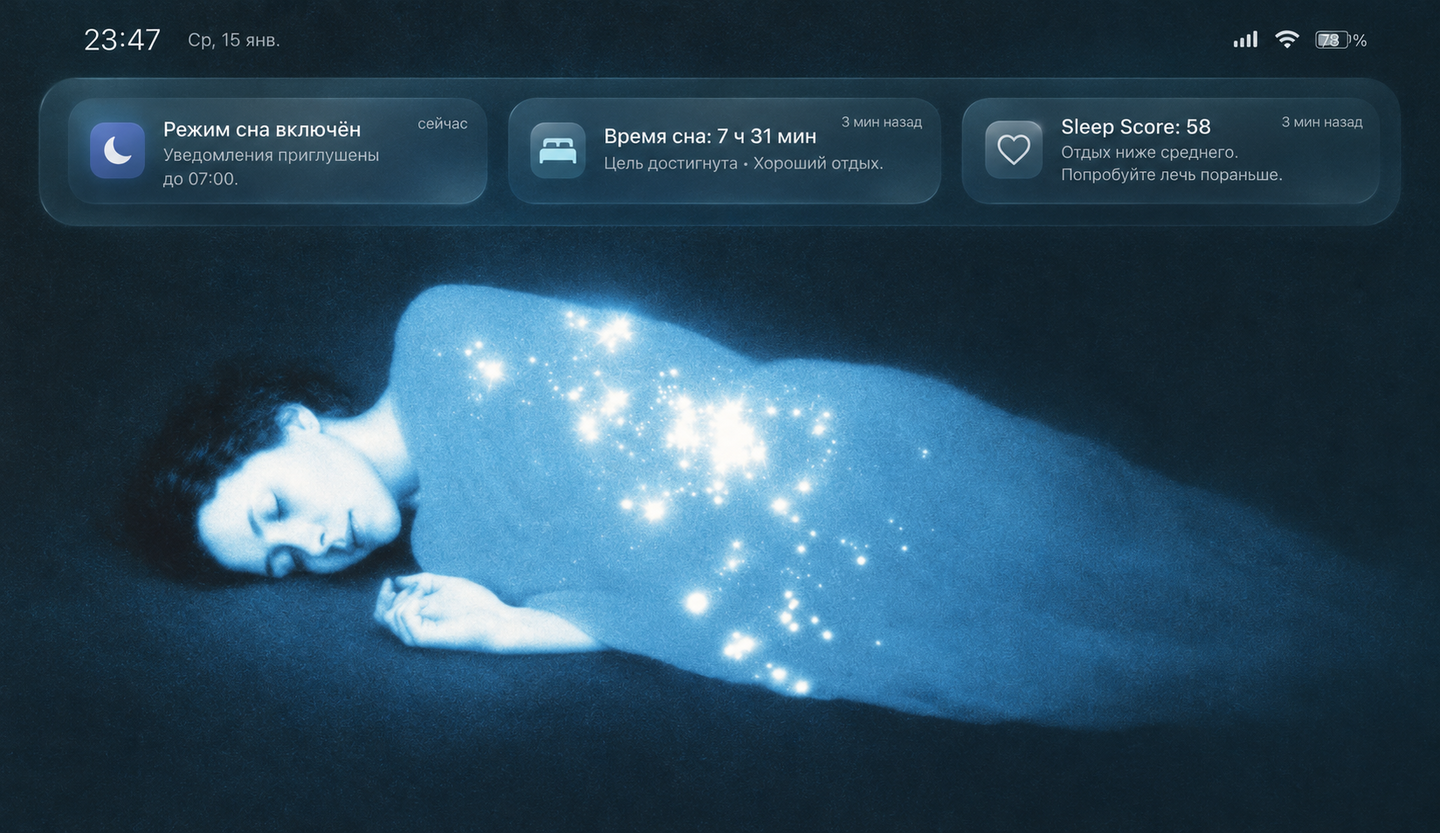
«СПАТЬ НОРМАЛЬНО»
Медиа о сне для тех, кто устал даже отдых делать правильно
Концепция медиа
Наше медиа посвящено культуре сна и восстановления в современной жизни. Мы исследуем, как цифровая среда, рабочие привычки, стресс и повседневные решения влияют на качество отдыха.
Ключевая задача — сделать научную информацию о сне понятной, доступной и применимой в реальной жизни. Мы не предлагаем универсальных рецептов, не романтизируем продуктивность и не превращаем сон в ещё одну обязанность.
Цель
Помочь аудитории осознаннее относиться к собственному сну, понимать причины усталости и формировать более здоровые отношения с отдыхом.
Аудитория
Молодые люди, студенты и работающие специалисты, которые сталкиваются с недосыпом, информационной перегрузкой и сложностями с восстановлением.
Позиционирование
Научно обоснованное медиа о сне без запугивания, псевдонауки и давления идеей идеального образа жизни.
УТП. Медиа о культуре сна, которое простым языком объясняет научные исследования, развенчивает мифы и помогает улучшать качество отдыха без давления и сложных правил.
Каналы и ритм. Основной канал — Telegram, 2–3 поста в неделю. Дополнительно — короткие видео, инфографика и опросы.
Рубрики. «Наука сна», «Миф или правда?», «Сон и технологии», «Ритуалы восстановления», «Почему мы не высыпаемся».
Для этого ДЗ важно: медиа работает с научными данными, поэтому ИИ помогает искать, собирать и структурировать информацию, а человек проверяет факты, формулирует выводы и отвечает за финальный контент.
Источники данных для медиа
В основе нашего медиа — научные исследования о сне, официальная статистика и опыт аудитории. Научные источники помогают создавать достоверный контент, а вопросы подписчиков и аналитика показывают, какие темы наиболее актуальны. Всего мы выделяем девять основных источников данных.
Принцип работы с источниками. Научные факты мы проверяем по первоисточникам, а личный опыт подписчиков не выдаём за доказанные закономерности. ИИ помогает собирать и систематизировать данные, но окончательное решение об их использовании принимает редактор.
Схема данных
Каждый материал нашего медиа проходит семь этапов.
Машина выполняет повторяющиеся задачи: собирает исследования, сортирует информацию, выделяет факты, проверяет текст и публикует посты по расписанию. Человек выбирает темы, проверяет достоверность данных, формулирует выводы и отвечает за финальное содержание.
Граница проходит по одному принципу: машина работает с данными, человек — со смыслом. Поскольку медиа затрагивает вопросы здоровья, выбор темы, проверка научных фактов и формулирование рекомендаций не передаются ИИ полностью.
Исключение: ИИ может помогать создавать иллюстрации и инфографику, но автор проверяет их достоверность, редактирует и утверждает перед публикацией.
Практический пример из контентного направления второго ДЗ
Пример: пост «Можно ли доверять Sleep Score в приложении?»
Как материал рубрики «Сон и технологии» проходит семь этапов обработки.
1. Сбор. Автор выбирает тему оценки сна в приложениях. Машина собирает научные материалы о трекерах сна и принципах измерения его качества.2. Отбор. ИИ группирует найденную информацию и выделяет основные вопросы. Автор выбирает главный: насколько точно приложение оценивает качество сна?3. Подготовка. Машина составляет краткий конспект исследований. Автор проверяет первоисточники и формулирует главную мысль: оценка приложения не равнозначна медицинской диагностике.4. Создание. Автор пишет текст и создаёт карточки с примером Sleep Score 58. ИИ помогает подготовить структуру и адаптировать изображения под формат публикации.5. Проверка. Машина исправляет опечатки и проверяет ссылки. Автор сверяет научные утверждения и вычитывает материал.6. Публикация. Утверждённый пост автоматически выходит в Telegram. Автор отвечает на вопросы подписчиков и предлагает обсудить использование трекеров сна.7. Аналитика. Система собирает просмотры, реакции и результаты обсуждения. Автор решает, стоит ли продолжать тему умных часов и приложений для сна.
Правила для каждого сервиса
Гайдлайны для автоматизированных сервисов
Автоматизация в нашем медиа помогает собирать научные данные, готовить черновики и анализировать публикации, но не принимает редакционных решений самостоятельно.
Ниже — шесть общих правил и инструкции для каждого сервиса из нашей схемы.
Общие правила 1. Выводы и финальный текст — за автором. ИИ не формулирует самостоятельные медицинские рекомендации. Все научные утверждения и итоговый материал проверяет человек.2. Каждый факт — из первоисточника. Статистика, результаты исследований и рекомендации сопровождаются ссылками. Автор проверяет их достоверность и контекст.3. Личные данные не передаются нейросетям. Перед обработкой комментариев и опросов удаляются имена, контакты и другая личная информация.4. Всё машинное помечено. Результаты ИИ содержат дату, источник и статус «черновик». Сгенерированные иллюстрации обозначаются при публикации.5. Одна задача — один результат. Для каждого сервиса определены входные данные, правила обработки и единый формат ответа.6. Медиа работает без автоматизации. Любой этап можно выполнить вручную. При повторяющихся ошибках сервис отключается до проверки.
Шаблон запроса для чернового конспекта
Ты — помощник редактора научно-популярного медиа о сне.
Перед тобой научная публикация: [название, текст и ссылка].
Выдели до 7 ключевых фактов о сне и восстановлении.
К каждому факту добавь точную цитату из исследования и укажи её расположение в тексте.
Отдельно отметь ограничения исследования.
Не придумывай данные, не давай медицинских советов и не формулируй собственных выводов.
Если информация отсутствует, напиши «не указано».
Формат: факт — цитата — ограничение — источник.