«ЛИПА» — медиа о громких подделках и фальсификациях.
Мы разбираем реальные истории из искусства, науки, истории и массовой культуры и показываем, как возник обман, почему ему поверили и что в итоге помогло раскрыть правду.
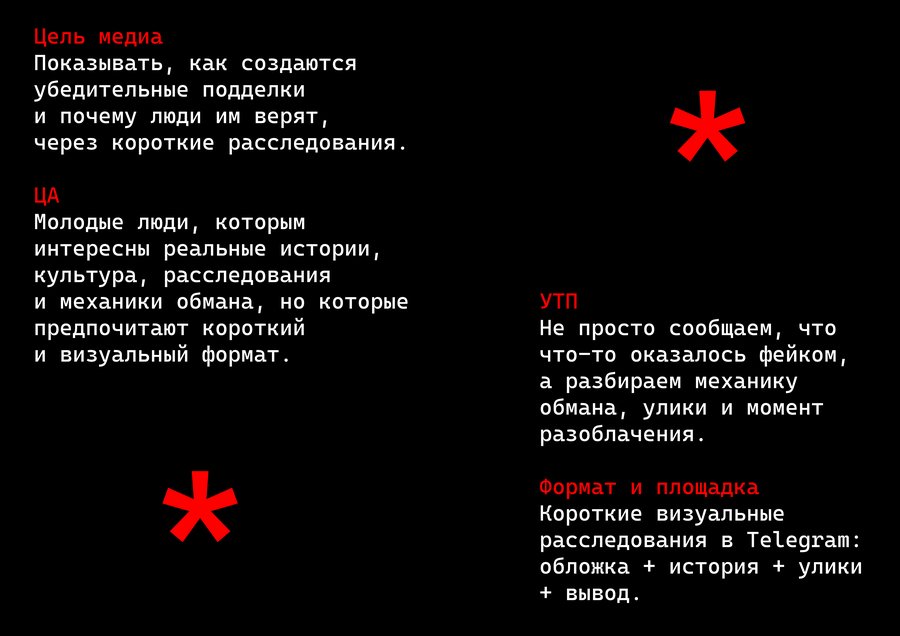
Источники данных
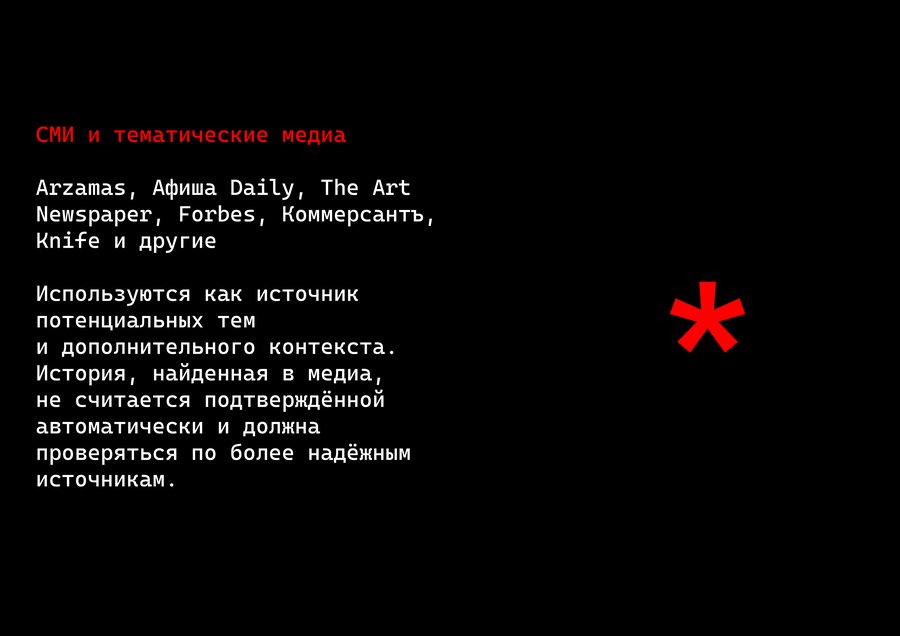
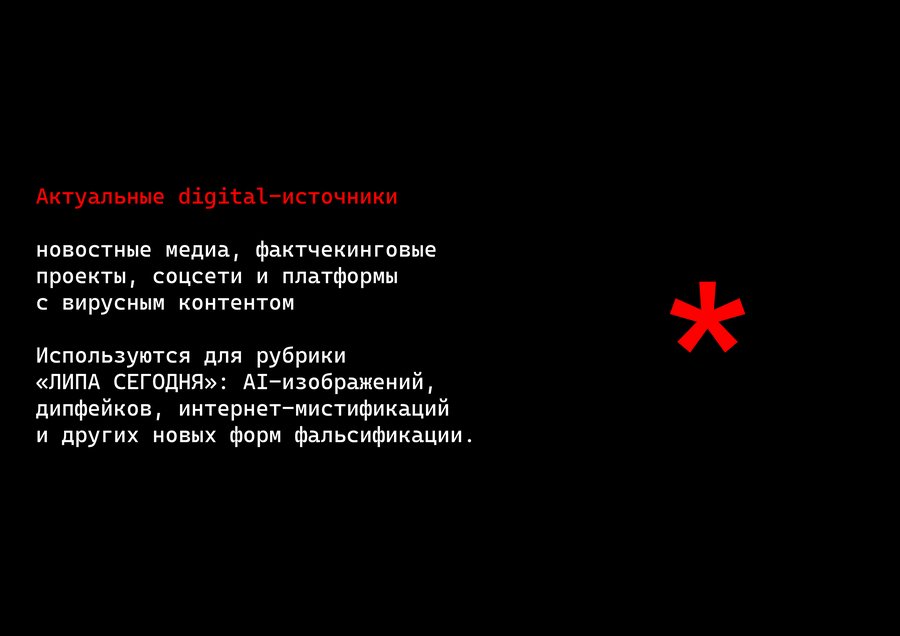
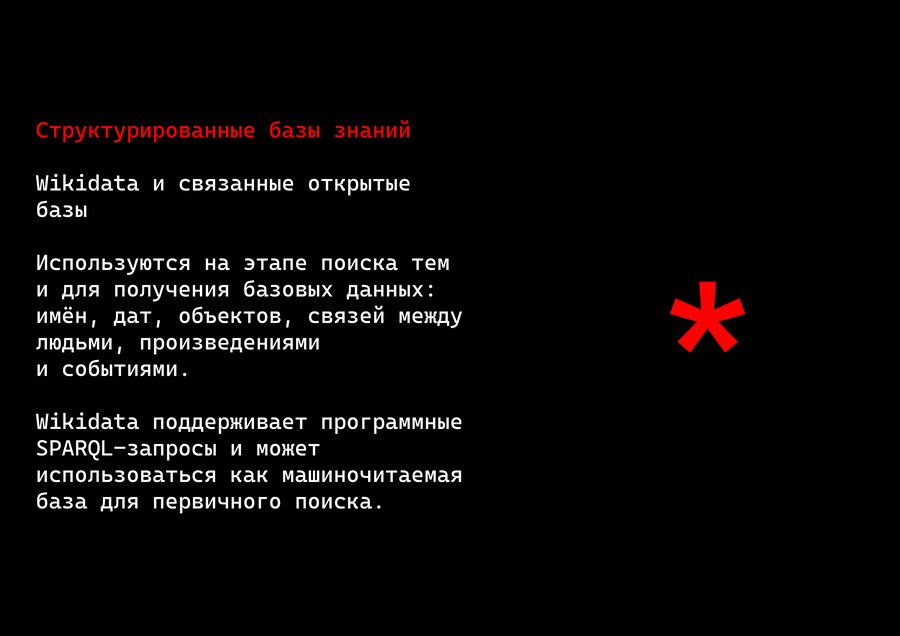
Для поиска историй и подготовки материалов «ЛИПА» использует несколько уровней источников. Автоматизированная система может находить потенциальные кейсы в медиа и открытых базах, но ключевые факты проверяются по первичным и институциональным источникам.
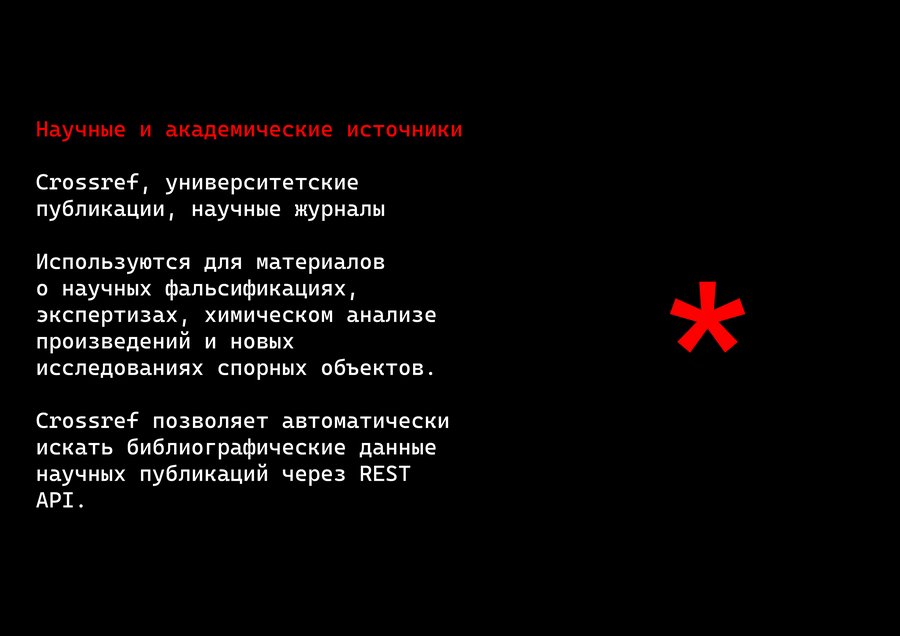
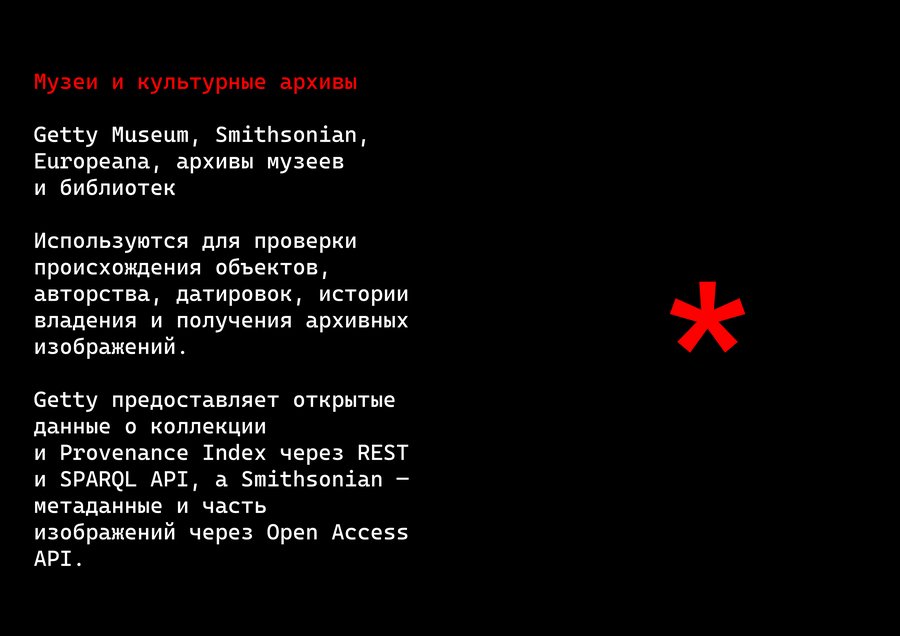
Приоритет источников
Первичные документы и музейные / научные базы → академические публикации → крупные СМИ → тематические медиа → соцсети.
Чем ниже источник находится в этой цепочке, тем меньше он используется как доказательство и тем больше — как сигнал для поиска новой истории.
Данные хранятся в трех связанных таблицах:
Источники: идентификатор, название, ссылка, тип источника, дата публикации, автор, уровень надёжности, язык, изображения и статус проверки.
Истории: идентификатор, название, тема, рубрика «ЛИПЫ», краткое описание, ключевые факты, подтверждённые и спорные факты, связанные источники и статус подготовки.
Публикации: идентификатор, связанная история, заголовок, текст, формат, визуал, площадка, дата выхода, просмотры, реакции, сохранения и пересылки.
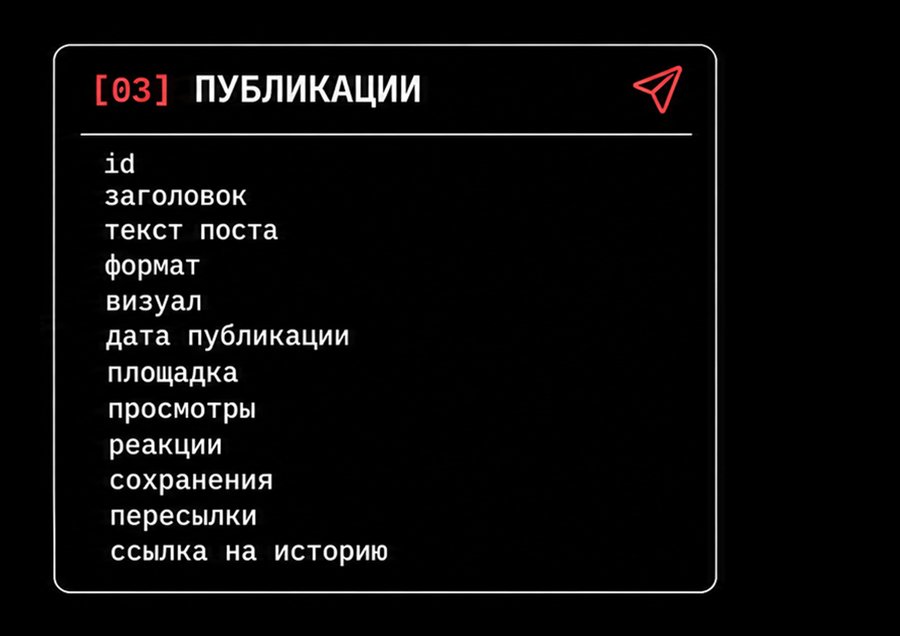
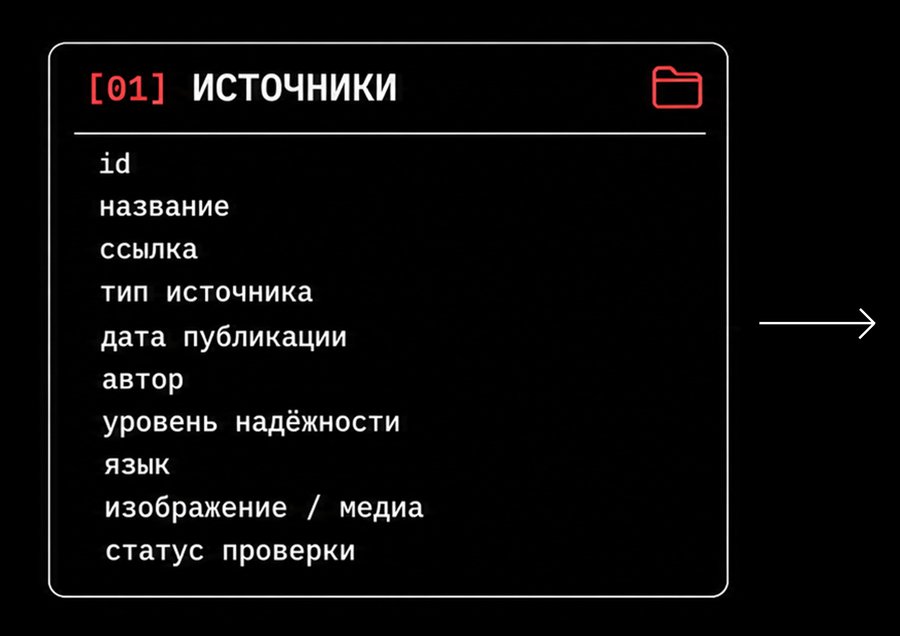
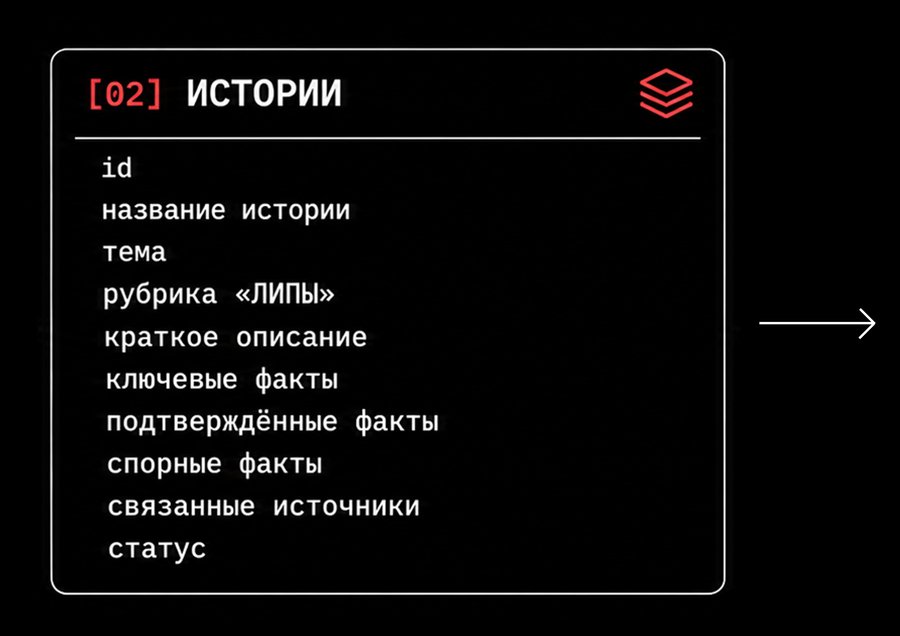
Источники дают факты → истории объединяют их в кейс → публикации превращают кейс в готовый материал.
Гайдлайны для автоматизированных сервисов в схеме
Гайдлайн 02: исследование и фактчек
Гайдлайн 03: генерация текста
Гайдлайн 04: создание визуала
Гайдлайн 05: публикация и аналитика
Автоматизация «ЛИПЫ» берёт на себя поиск, сбор, систематизацию и подготовку контента, но не заменяет редактора.
Ключевые решения остаются за человеком: он проверяет достоверность информации, работает со спорными версиями и утверждает материал перед публикацией.
Так система ускоряет производство контента, сохраняя главное для медиа о фейках — доверие к фактам.