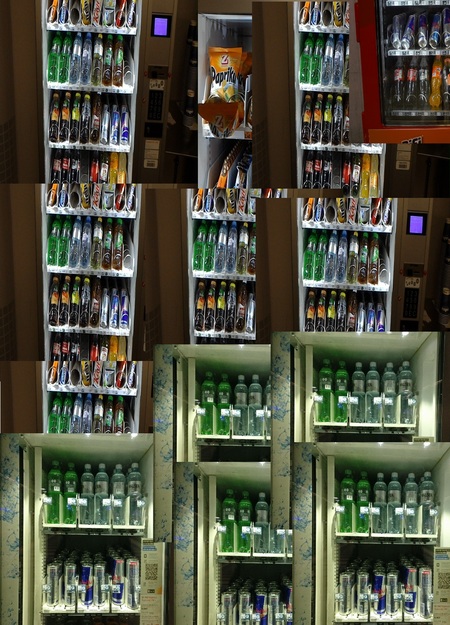
Идея проекта
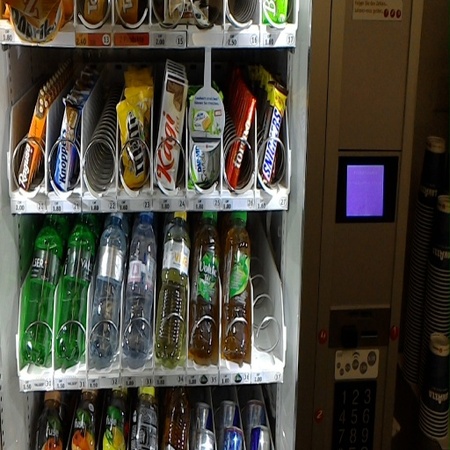
Современные генеративные модели изображений ориентированы на создание максимально чистых, детализированных и фотореалистичных изображений. Однако такая визуальная «идеальность» со временем становится предсказуемой и однообразной. В рамках данного проекта исследуется альтернативный подход, при котором внимание смещается с точного воспроизведения на интерпретацию и трансформацию объекта.
В качестве основного объекта выбран вендинговый автомат. Это распространённый элемент городской среды, связанный с темами серийности, повторяемости и потребления. Цель проекта заключается в исследовании того, как нейросеть сохраняет узнаваемую структуру объекта, одновременно изменяя его детали и визуальную логику.
Выбор объекта
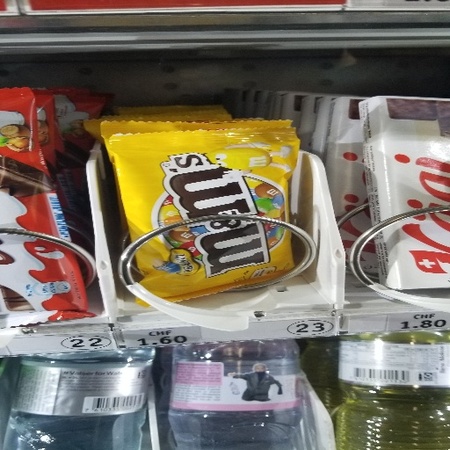
Вендинговый автомат представляет собой сложный и визуально насыщенный объект. Он обладает регулярной структурой и включает в себя множество повторяющихся элементов. Ключевые характеристики объекта включают:
фронтальную композицию; чёткую сетку расположения товаров; разнообразие цветов и текстур.
Такая структура делает объект удобным для обучения модели, поскольку она может выделить устойчивые закономерности. При этом большое количество деталей создаёт условия для их последующего упрощения и переосмысления в процессе генерации.
Исходные изображения для обучения
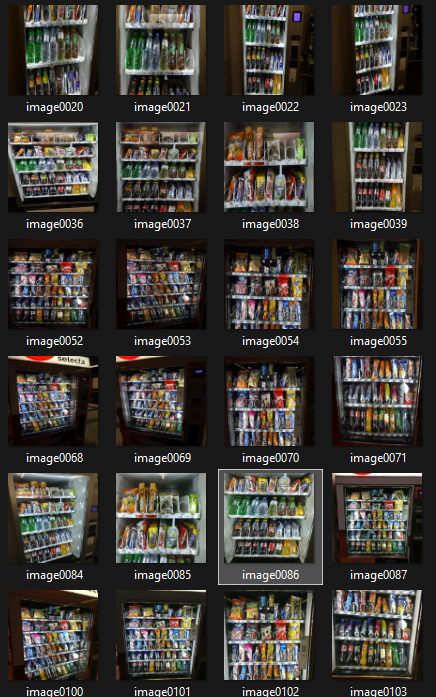
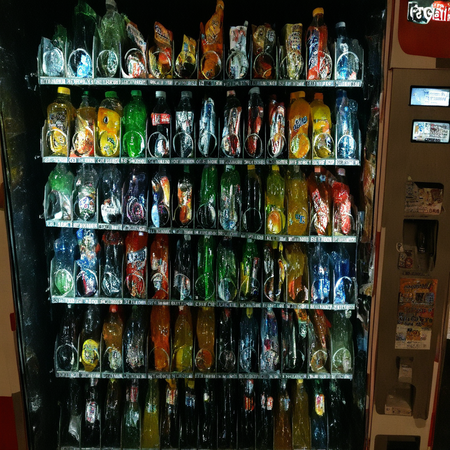
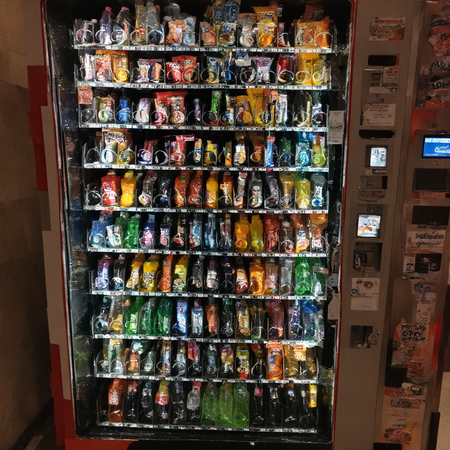
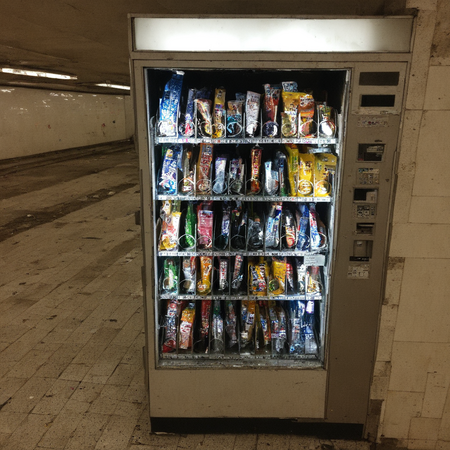
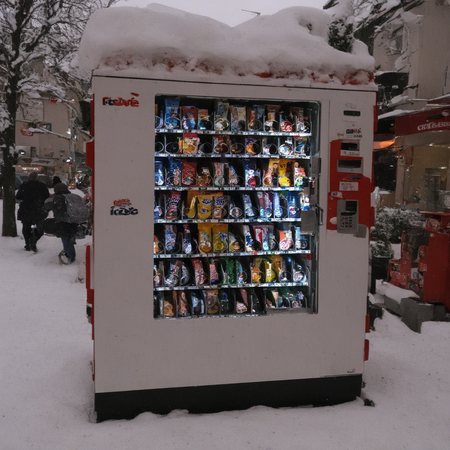
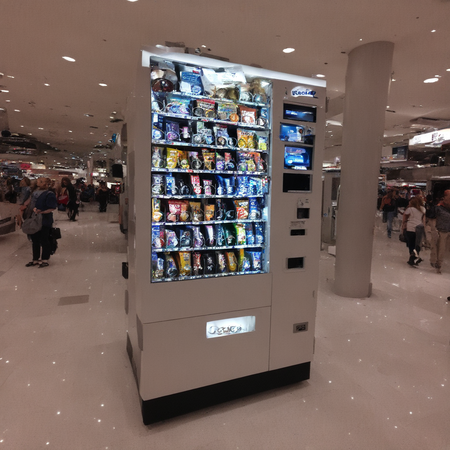
Для обучения был собран датасет изображений вендинговых автоматов с напитками. В выборку вошли изображения с различными условиями съёмки, освещением и наполнением автомата.
Основные характеристики датасета:
преимущественно фронтальные ракурсы; различная цветовая насыщенность; разнообразие визуального содержания.
Это позволило модели сформировать обобщённое представление об объекте, а не запомнить конкретные изображения.
Все изображения использованы в соответствии с требованиями задания и условиями лицензирования. CC0: Public Domain
Процесс обучения модели
В проекте использовалась модель Stable Diffusion XL, дообученная методом DreamBooth LoRA.
Процесс включал следующие этапы:
Подготовка датасета и размещение изображений в рабочей директории. Создание текстовых описаний для каждого изображения. Дообучение модели с использованием LoRA, что позволило адаптировать модель под новый объект без изменения всей архитектуры. Сохранение полученных весов. Генерация изображений на основе обученной модели.
Обучение проводилось в среде Google Colab. Ссылка на файл https://disk.yandex.ru/d/WeSzURZlA_xz0w
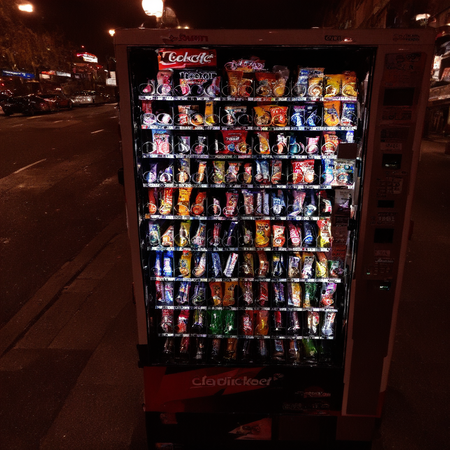
В результате была получена серия изображений вендинговых автоматов, сгенерированных моделью.
Общие характеристики серии:
сохранение фронтальной композиции; наличие вертикальной структуры и рядов; высокая цветовая насыщенность; вариативность в деталях и текстурах.
Изображения различаются по степени абстракции и детализации, при этом остаются узнаваемыми.
Визуальный анализ результатов
Анализ полученной серии позволяет выделить несколько ключевых особенностей.
Сохранение структуры
Модель стабильно воспроизводит общую форму вендингового автомата. Присутствует фронтальный ракурс и характерное деление на ряды.
Трансформация деталей
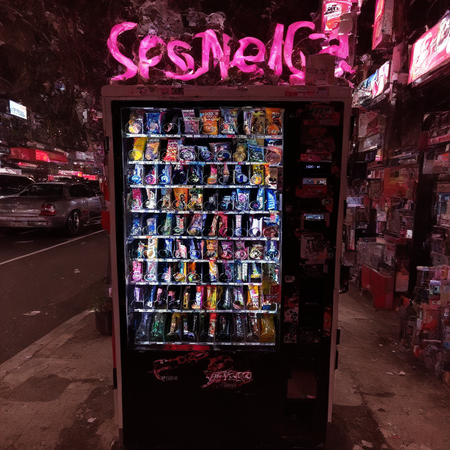
Отдельные элементы не воспроизводятся буквально. Бутылки и упаковки часто превращаются в обобщённые формы и цветовые области.
Визуальная насыщенность
Изображения содержат большое количество цветовой информации. Это усиливает ощущение плотности и делает композицию более интенсивной по сравнению с реальными изображениями.
Нарушение читаемости
Текстовые элементы и мелкие детали становятся нечёткими или искаженными. Это связано с тем, что модель оперирует визуальными паттернами, а не символами.
Интерпретация результата
Полученные изображения демонстрируют, что генеративная модель способна сохранять ключевые признаки объекта, одновременно трансформируя его внутреннюю структуру.
Искажения и упрощения в данном случае не являются ошибкой. Они отражают способ, которым модель обобщает визуальную информацию и формирует новое представление объекта.
В результате вендинговый автомат становится не только предметом, но и визуальным образом, в котором сочетаются узнаваемость и вариативность.
Сгенерированные изображения отличаются друг от друга по нескольким параметрам:
уровень детализации; цветовая доминанта; степень искажения формы.
Некоторые изображения ближе к реалистичному виду, другие демонстрируют более выраженную трансформацию. Это показывает диапазон возможностей модели при работе с одним объектом.
В проекте использовались следующие инструменты:
Stable Diffusion XL с дообучением через DreamBooth LoRA для генерации изображений; ChatGPT для помощи в формулировании текста и структурировании описания.
Основной результат проекта, серия изображений, был получен с использованием обученной модели.
Вывод
Проект демонстрирует, что генеративные модели могут не только воспроизводить объекты, но и интерпретировать их. Даже при сохранении общей структуры происходит трансформация деталей и формируется новое визуальное качество.
Полученные результаты подтверждают, что генерация изображений может рассматриваться не только как инструмент копирования, но и как способ создания самостоятельных визуальных интерпретаций.