о проекте
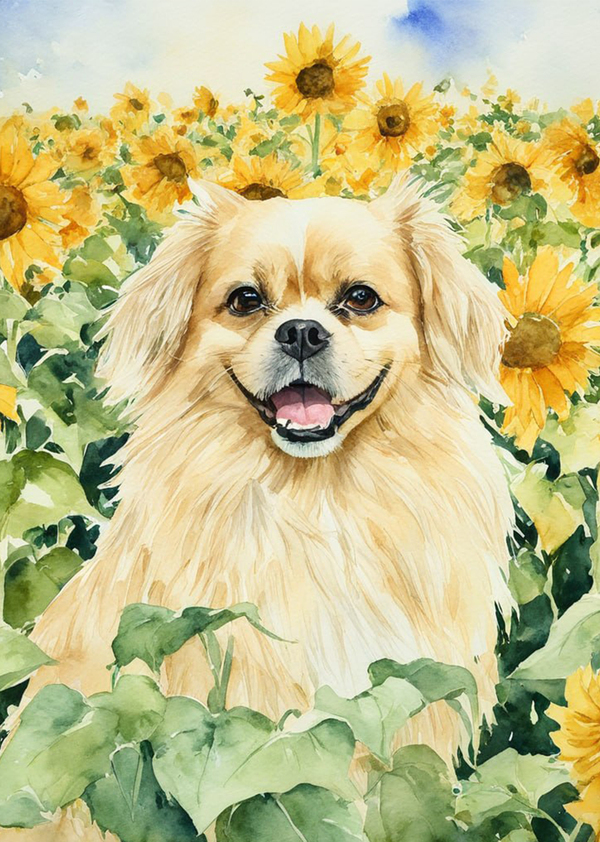
Идея проекта заключается в создании персональной генеративной модели на базе Stable Diffusion, способной создавать высококачественные и стилистически разнообразные изображения моей собаки по кличке Аки. В качестве исходных данных (датасета) используются личные фотографии питомца. Цель — проверить, насколько точно нейросеть способна уловить уникальные черты внешности Аки (окрас, форму морды, характерный взгляд) и перенести их на новые изображения, сохраняя при этом заданный художественный стиль (например, киберпанк, акварель, масляная живопись, стимпанк).
Исходные изображения для обучения
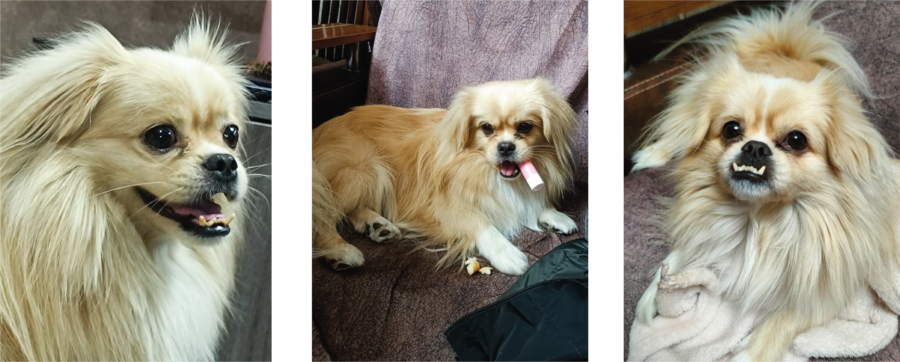
Для формирования датасета было отобрано 30-40 фотографий Аки. Главные требования к фото: четкость, хорошее освещение, отсутствие размытия. Чтобы нейросеть не перепутала собаку с фоном, использовались снимки с разных ракурсов, но преимущественно с акцентом на мордочку.
первая пробная картинка
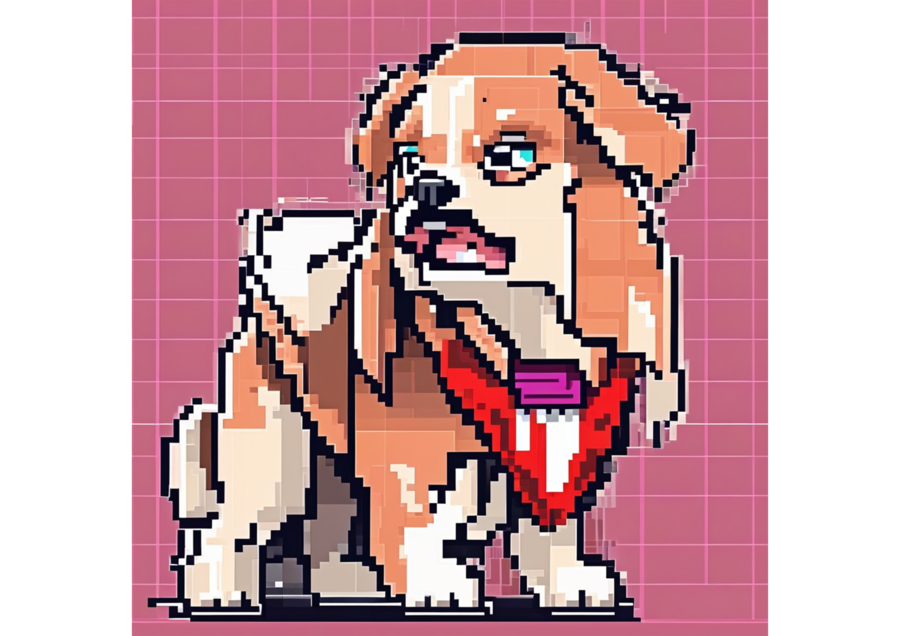
промт: A pixelated drawing of an Aki dog
тут мы можем заметить что из-за краткого промта, не смог передать нужную картинку
самая удачная работа
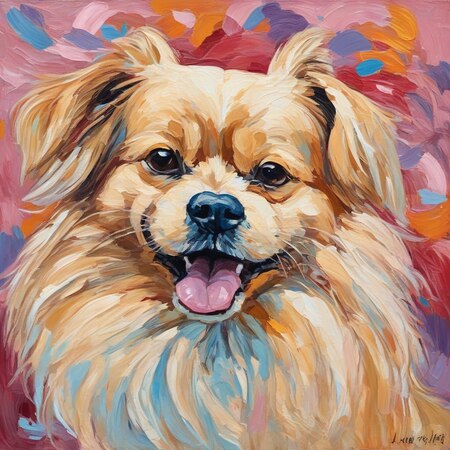
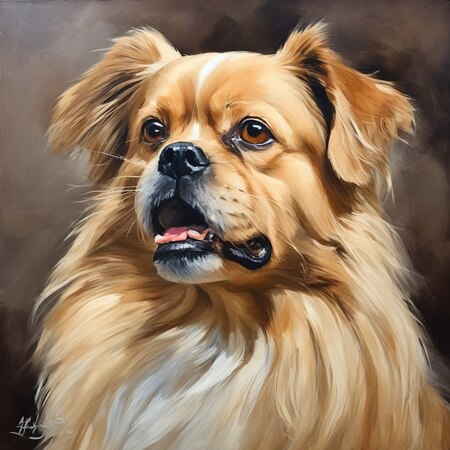
промты: 1. a post-impressionist oil painting of aki dog, thick swirling brush strokes 2. a classical oil portrait of aki dog, dramatic lighting, rich brush strokes
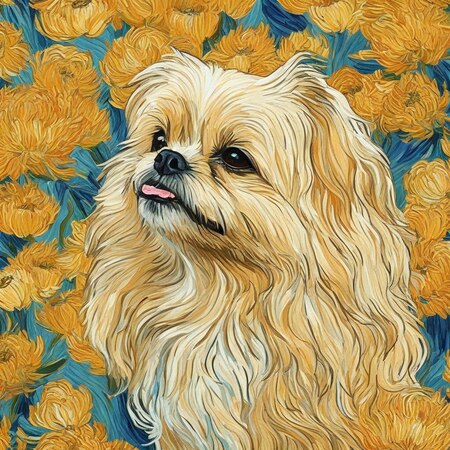
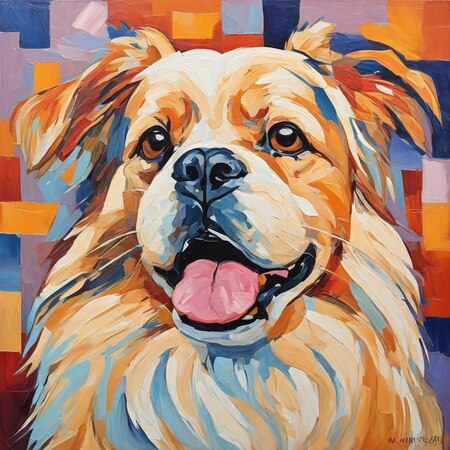
промты: 1. Image of aki dog in style of Van Gogh painting 2.Impressionist painting of aki dog. keep it abstract in style of cubism
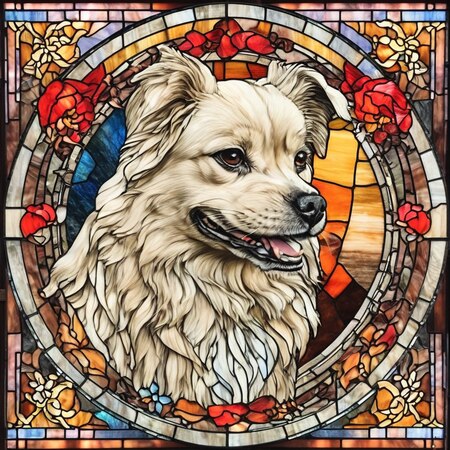
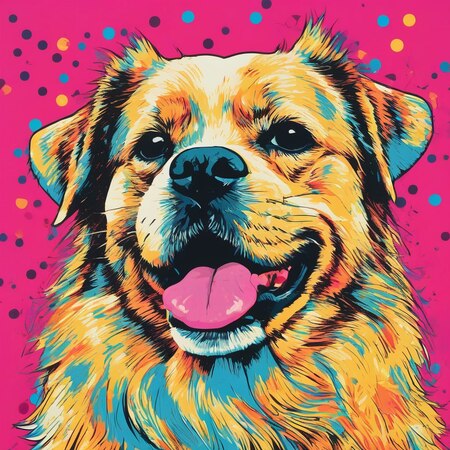
промты: 1. a stained glass window depicting aki dog, vivid colors, black lead lines 2. a stained glass window depicting aki dog, vivid colors, black lead lines
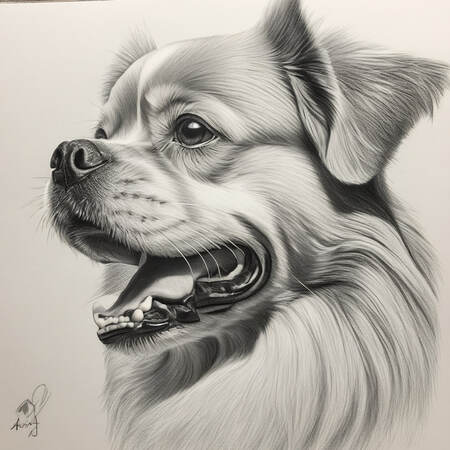
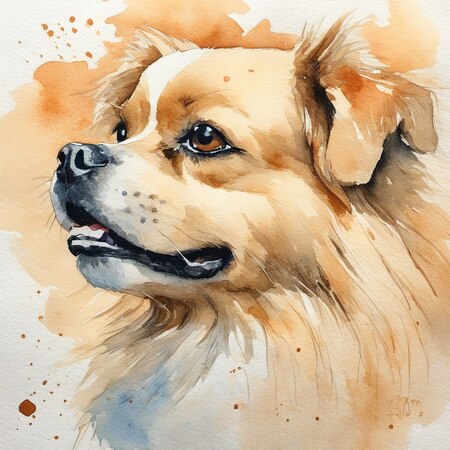
промты: 1. a detailed graphite pencil sketch of aki dog, cross-hatching, white paper 2. a loose watercolor painting of aki dog, soft washes, visible paper texture
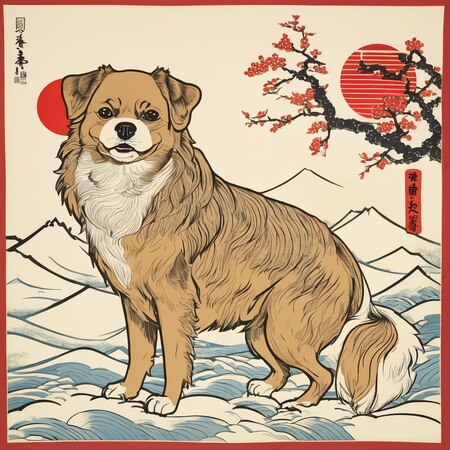
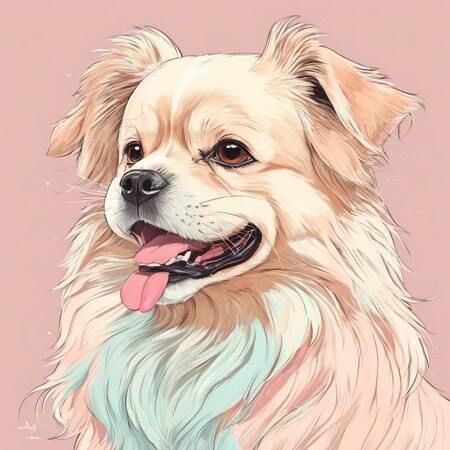
промты: 1. a Japanese ukiyo-e woodblock print of aki dog, flat colors, bold outlines 2. an anime illustration of aki dog, soft pastel colors, clean line art
промт: a stylized 3D cartoon render of aki dog, soft studio lighting, big expressive eyes
Разбор кода
Данный скрипт на языке Python предназначен для автоматизированной подготовки и предобработки набора изображений (датасета) для последующего обучения нейросетей.
Основные этапы работы скрипта:
Инициализация: Настраивается поддержка формата .heic (фото с iOS), задаются допустимые расширения файлов и максимальное ограничение по высоте/ширине (2048 пикселей).
Подготовка директории: Целевая папка для сохранения (/content/dog_train) полностью очищается и реконструируется.
Фильтрация данных: Код рекурсивно сканирует исходный каталог, отсеивая неподходящие форматы файлов и служебные системные файлы (например, служебные файлы macOS).
Обработка графики: Изображения приводятся к цветовой модели RGB, корректируется их ориентация на основе метаданных EXIF, а размеры пропорционально масштабируются (сжатие методом Lanczos до максимальной стороны 2048 пикселей).
Сохранение и стандартизация: Обработанные файлы сохраняются в формате JPEG с качеством 95% и порядковой нумерацией вида img_000.jpg.
Валидация: По завершении проверяется количество файлов и их разрешение. Если итоговый набор пуст, генерируется исключение; при малом количестве снимков (менее 5) или низком разрешении (менее 512 пикселей) выводятся соответствующие предупреждения.
Данный фрагмент кода на языке Python предназначен для автоматической генерации текстовых описаний (кэпшенов) к подготовленным изображениям с использованием модели BLIP, после чего эти описания сохраняются в специальный JSON-файл разметки (обычно используемый для обучения генеративных моделей, таких как Stable Diffusion).
Основные этапы работы кода:
Инициализация метаданных: Задается путь к файлу metadata.jsonl в директории TRAIN_DIR, и если такой файл существовал ранее, он удаляется (meta_path.unlink).
Загрузка модели BLIP: Если активирован флаг USE_BLIP_CAPTIONS, скрипт загружает предобученную модель Salesforce/blip-image-captioning-base и её процессор из библиотеки transformers. Модель переносится на устройство GPU (cuda) с половинной точностью (torch.float16) для экономии памяти.
Функция генерации кэпшена (caption_image): Принимает изображение, обрабатывает его через процессор, генерирует текстовое описание с помощью модели BLIP и возвращает декодированную первую строку текста.
Обход датасета и разметка: Скрипт открывает файл metadata.jsonl для записи и последовательно перебирает все изображения из папки TRAIN_DIR:
Для каждого изображения генерируется текстовое описание.
Формируется итоговый промпт, объединяющий заданный ключевой маркер объекта (INSTANCE_PROMPT) и сгенерированное моделью описание ({INSTANCE_PROMPT}, {caption_image (…)}).
Результат записывается в файл в формате JSON Lines (json.dumps), где для каждого файла (file_name) прописывается соответствующий текст (prompt).
Освобождение памяти: После завершения генерации кэпшенов объекты модели и процессора удаляются (del), вызывается сборщик мусора (gc.collect ()), а кэш CUDA очищается (torch.cuda.empty_cache ()), освобождая видеопамять перед следующим этапом (обучением).
Альтернативная ветка (else): Если генерация кэпшенов отключена (USE_BLIP_CAPTIONS = False), скрипт выводит уведомление о том, что для всех фотографий будет использоваться единый базовый INSTANCE_PROMPT
Данный фрагмент кода предназначен для конфигурации гиперпараметров обучения модели LoRA и формирования аргументов командной строки через интерактивные виджеты Jupyter. В нем задаются такие параметры, как целевая директория для сохранения результатов (OUTPUT_DIR = «dog_style_LoRA»), разрешение изображений (RESOLUTION = 512), максимальное число шагов обучения (MAX_TRAIN_STEPS = 0), частота сохранения чекпоинтов (CHECKPOINT_EVERY = 100) и ранг сети LoRA (RANK = 8). Если значение MAX_TRAIN_STEPS установлено на ноль, скрипт автоматически рассчитывает оптимальное количество шагов на основе общего числа подготовленных изображений (n_images * 25, в диапазоне от 300 до 800 шагов), выводя подробную статистику в консоль. В зависимости от того, использовалась ли ранее автоматическая генерация текстовых описаний (USE_BLIP_CAPTIONS), переменная DATA_ARGS формирует аргументы либо для обучения по датасету с разметкой (--dataset_name и --caption_column)
Данный фрагмент кода запускает процесс обучения модели LoRA для Stable Diffusion XL с помощью утилиты accelerate и скрипта train_dreambooth_lora_sdxl.py, передавая ему все ранее настроенные параметры. В командной строке задаются базовые пути к предобученной модели (stabilityai/stable-diffusion-xl-base-1.0) и VAE (madebyollin/sdxl-vae-fp16-fix), динамически сформированные аргументы датасета ({DATA_ARGS}), директория для сохранения результатов ({OUTPUT_DIR}) и базовый промпт объекта ({INSTANCE_PROMPT}). Также настраиваются технические параметры оптимизации: использование смешанной точности fp16, размер изображения ({RESOLUTION}), обрезка по центру (--center_crop), размер батча (--train_batch_size=1), накопление градиентов (--gradient_accumulation_steps=4), чекпоинтинг градиентов и оптимизатор 8bit_adam для экономии видеопамяти. Дополнительно передаются гиперпараметры обучения: ранг LoRA ({RANK}), скорость обучения (--learning_rate=1e-4), коэффициент SNR (--snr_gamma=5.0), тип планировщика learning rate (constant), общее число шагов ({max_steps}), частота сохранения чекпоинтов ({CHECKPOINT_EVERY}) и фиксированное зерно генерации (--seed=0).
Данный фрагмент кода предназначен для резервного копирования и экспортного сохранения результатов обучения модели LoRA на Google Диск или в удаленный репозиторий Hugging Face Hub в зависимости от выбранных настроек. В первом блоке, при включенном флаге SAVE_TO_DRIVE, скрипт монтирует Google Диск (drive.mount), выполняет поиск сохраненных весов pytorch_lora_weights.safetensors во всех папках с чекпоинтами и итоговой директории, после чего копирует их в указанную пользовательскую папку (DRIVE_SAVE_DIR). Во втором блоке, при активации PUSH_TO_HUB, код извлекает токен авторизации HF_TOKEN, автоматически создает приватный репозиторий на платформе Hugging Face Hub и загружает туда финальную модель, исключая промежуточные чекпоинты для экономии места и высылая прямую ссылку на созданный репозиторий.
Данный фрагмент кода предназначен для загрузки и инициализации обученной модели LoRA совместно с базовой диффузионной моделью для генерации изображений (инференса). В начале задаются интерактивные параметры: путь к сохраненным весам LoRA (LORA_PATH) и коэффициент её влияния (LORA_SCALE = 0.8). Затем скрипт загружает вариационный автоэнкодер (vae) и основной пайплайн модели stable-diffusion-xl-base-1.0 с использованием формата safetensors и половинной точности fp16 для оптимизации потребления видеопамяти. После этого с помощью метода pipe.load_lora_weights подгружаются ранее натренированные веса LoRA по указанному пути, а весь пайплайн переносится на графический процессор (cuda) для быстрой работы.